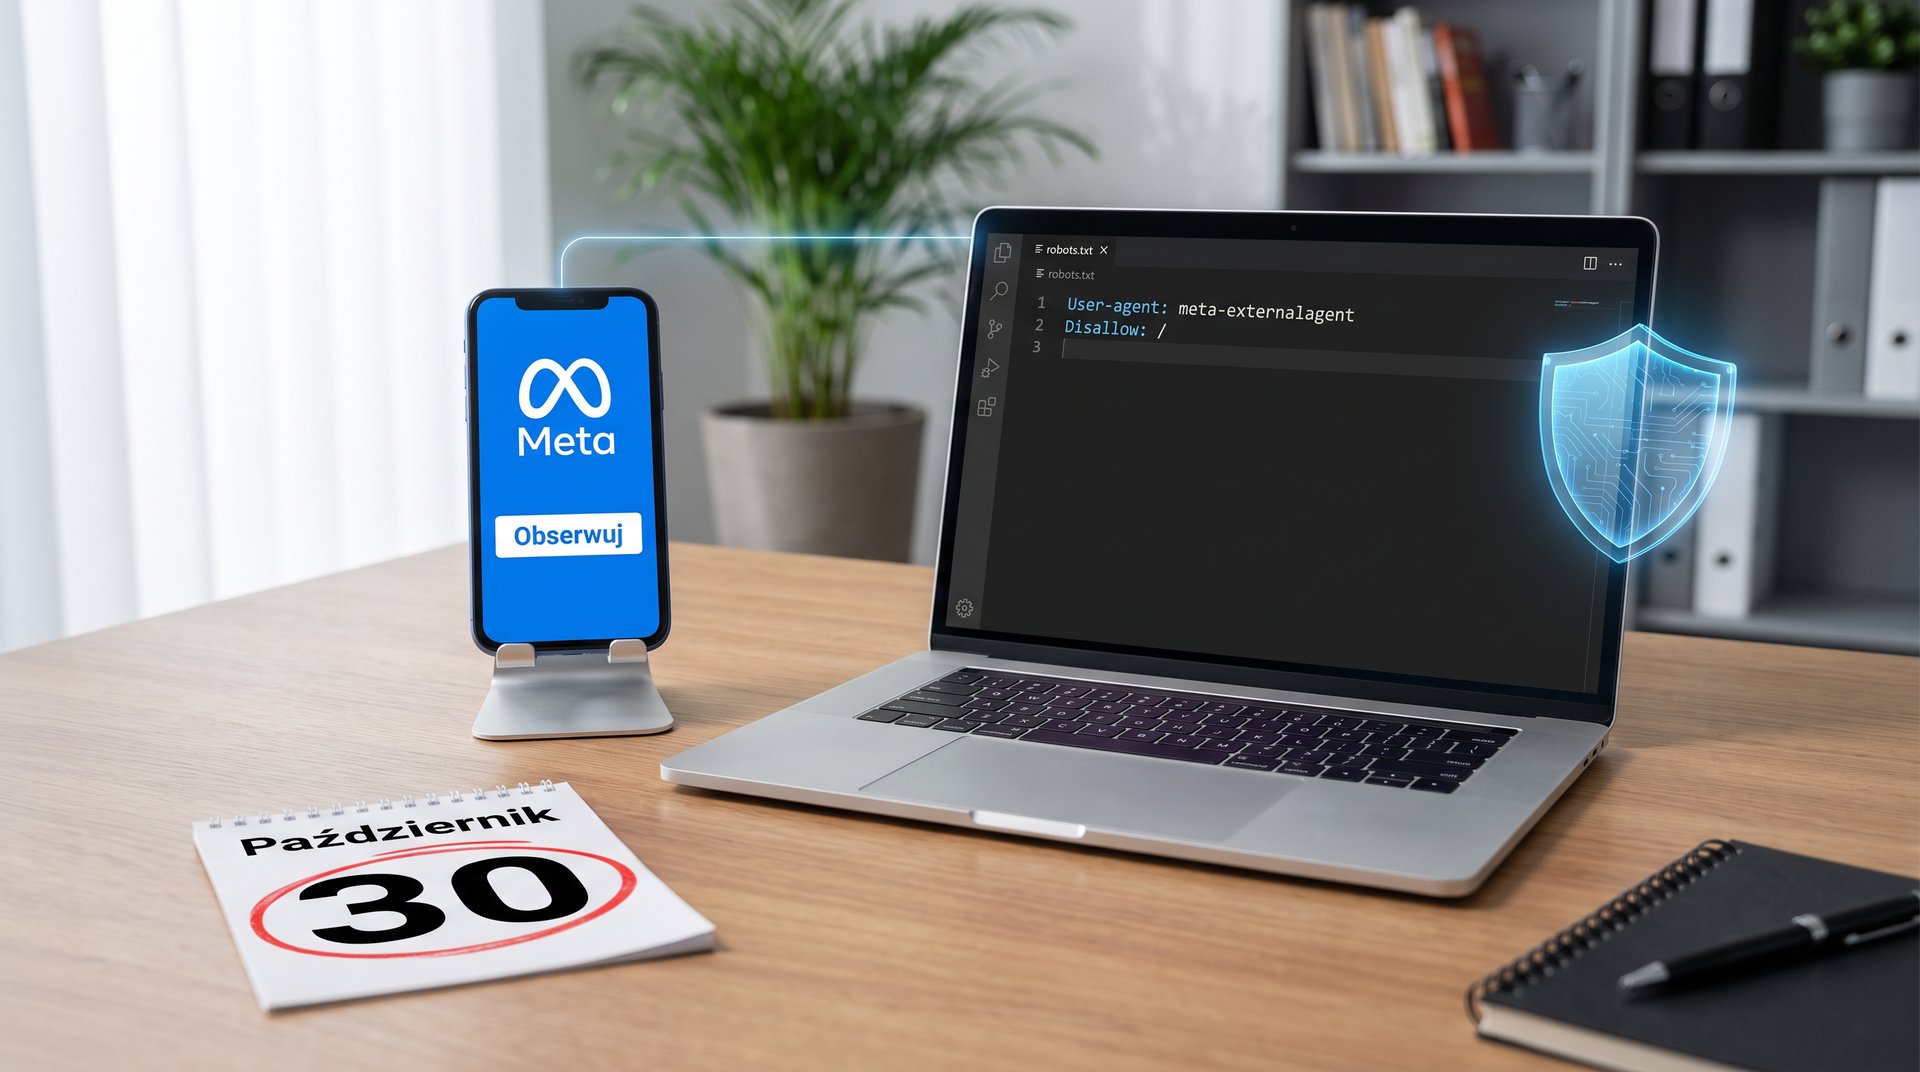
30 października 2026 r. wchodzi w życie nowy regulamin handlowy Meta. Wystarczy, że Twoja firma ma fanpage, i już Cię dotyczy. Regulamin daje Meta prawo do wysyłania botów na Twoją stronę internetową. Opcji „nie zgadzam się” nie ma.
Meta twierdzi, że to tylko porządki w dokumentach. Część zapisów faktycznie była już wcześniej. Ale jedno da się zrobić od ręki i warto to zrobić przed 30.10: dopisać kilka linijek do pliku robots.txt.
Poniżej wyjaśniamy, co jest w regulaminie, co robots.txt załatwi, a czego nie, i dajemy gotowy blok do wklejenia.
Czy nowy regulamin Meta dotyczy Twojej firmy?
Prawie na pewno tak. Regulamin handlowy obejmuje korzystanie z produktów Meta „w celach biznesowych lub handlowych”. Według polskiej wersji dokumentu chodzi m.in. o:
- zarządzanie Stroną (czyli fanpage firmy),
- reklamy i Menedżera reklam,
- Meta Business Suite,
- wiadomości marketingowe i sprzedaż,
- katalog produktów,
- grupę prowadzoną w celach biznesowych,
- usługi pomiarowe.
Ważne: nie musisz puszczać żadnych reklam. Sam fanpage firmy wystarczy. Tak samo konto firmowe na Instagramie czy WhatsApp Business używany do obsługi klientów.
Co jest w nowym regulaminie handlowym Meta
Regulamin upoważnia Meta „lub dowolny podmiot występujący w naszym imieniu” do korzystania ze „scraperów, botów, robotów, pająków, crawlerów i agentów użytkownika”. Te boty mogą wchodzić na domeny i strony „powiązane z produktami lub usługami użytkownika”. Mogą je indeksować, zapisywać w cache, analizować, gromadzić treści i „okresowo pobierać aktualizacje”.
Po ludzku: Meta może regularnie skanować stronę Twojej firmy.
Dwie rzeczy zwracają uwagę.
Dane logowania na potrzeby testów. Regulamin pozwala Meta tworzyć „dane logowania na potrzeby testów”. Prof. James Grimmelmann z Cornell (cytowany przez Nieman Lab) zwraca uwagę, że technicznie pozwala to Meta założyć konto jako fikcyjny użytkownik, czyli wejść za ścianę rejestracji. Meta nie odpowiedziała, czy dotyczy to treści płatnych.
Szkolenie AI. Polska wersja mówi, że Meta może wykorzystywać treści z Twojej domeny do „dostarczania, opracowywania, ulepszania, badania, szkolenia i utrzymywania integralności Produktów firmy Meta”.
Stan na 19.10: wersje regulaminu się różnią
Tu robi się ciekawie, bo tekst zmienia się w trakcie. Tak wyglądał podgląd regulaminu 19 października rano:
| Wersja regulaminu | Zdanie o szkoleniu / trenowaniu | Zakres |
|---|---|---|
| polska | jest | wszystkie produkty Meta |
| angielska (UK) | jest („train”) | wszystkie produkty Meta |
| angielska (USA) | usunięte | tylko produkty reklamowe i biznesowe oraz bezpieczeństwo |
17.10 The Verge napisał, że Meta usunęła zdanie o trenowaniu. Rzecznik Meta Daniel Roberts stwierdził, że zapisy o crawlowaniu dotyczyły tylko produktów reklamowych i biznesowych i że firma doprecyzowała to w samym regulaminie (cytujemy za PPC Land). W wersji amerykańskiej faktycznie to dopisano. Polska i brytyjska wersja na 19.10 nadal miały zdanie o szkoleniu.
Uczciwie: nie wiemy, jak będzie brzmiała polska wersja 30 października. Możliwe, że dostanie tę samą poprawkę co amerykańska. Nawet wtedy zostaje crawlowanie strony i dane logowania na potrzeby testów, a cała praktyczna część poniżej jest dalej aktualna.
Aktualny tekst sprawdzisz tu: podgląd regulaminu handlowego Meta.
Nie da się zrezygnować
Sekcja „Aktualizacje” regulaminu mówi wprost: jeśli dalej korzystasz z produktów Meta w celach biznesowych, akceptujesz zmiany. Jeśli nie akceptujesz, możesz „zaprzestać uzyskiwania dostępu do naszych Produktów lub korzystania z nich do celów biznesowych”. Według Nieman Lab przed 30.10 nie ma opcji opt-out dla kont firmowych.
Czyli wybór jest taki: zostajesz na Facebooku i Instagramie albo z nich wychodzisz. Dla większości małych firm to żaden wybór.
Jeśli puszczasz reklamy, część tego już podpisałeś
Żeby nie straszyć na wyrost: obecny regulamin reklam samoobsługowych Meta (obowiązuje od 22.08.2025) już daje Meta prawo do dostępu, indeksowania, cache'owania, analizowania i crawlowania treści Twoich domen, m.in. do „research and training”. Zgadzasz się na to, zamawiając reklamę.
Nowe są dwie rzeczy:
- zapis obejmuje każde konto firmowe, także sam fanpage albo WhatsApp Business bez żadnej reklamy,
- dane logowania na potrzeby testów.
Meta mówi, że zapisy o crawlowaniu były wcześniej rozrzucone po kilku regulaminach, teraz są w jednym miejscu, a sposób crawlowania się nie zmienia. I dodaje, że właściciele treści dalej mogą sterować dostępem przez robots.txt. Trzymamy ich za słowo.
Jak zablokować crawlery Meta w robots.txt
robots.txt to plik tekstowy w głównym katalogu strony (np. twojafirma.pl/robots.txt). Mówi botom, gdzie mogą wchodzić, a gdzie nie. Meta ma kilka botów i każdy robi co innego. Według dokumentacji crawlerów Meta (aktualizacja z 21.05.2026):
| User-agent | Do czego służy | Czy słucha robots.txt |
|---|---|---|
meta-externalagent | m.in. trenowanie modeli bazowych AI, indeksowanie do ulepszania produktów | tak |
meta-externalads | ulepszanie reklam i produktów biznesowych | tak |
meta-webindexer | wyniki wyszukiwania w Meta AI, cytowanie i linkowanie stron | dokumentacja nie podaje wyjątków |
facebookexternalhit | podgląd linku (tytuł, opis, miniatura) po udostępnieniu na FB, IG, w Messengerze | może pominąć przy kontrolach bezpieczeństwa |
meta-externalfetcher | pobieranie linków na prośbę użytkownika, agenci AI | może pominąć |
Gotowy blok do wklejenia
Ten blok blokuje boty od AI i od produktów reklamowych. Ułożyliśmy go na podstawie dokumentacji Meta, to nie jest oficjalny przykład Meta.
User-agent: meta-externalagent
Disallow: /

User-agent: meta-externalads
Disallow: /
Dopisz go do istniejącego robots.txt, nie zastępuj całego pliku. Reguły dla Google i innych wyszukiwarek mają zostać.
Nie blokuj facebookexternalhit
To najczęstsza pułapka. facebookexternalhit tworzy podgląd, gdy ktoś (albo Ty na swoim fanpage'u) wrzuca link do Twojej strony. Zablokujesz go, a posty z linkami stracą tytuł, opis i miniaturę. Dla firmy, która promuje stronę przez Facebooka, to strzał w kolano.
Decyzja: meta-webindexer i widoczność w Meta AI
meta-webindexer odpowiada za wyniki wyszukiwania w Meta AI. Według Meta dopuszczenie go pomaga, żeby Meta AI cytowała i linkowała Twoją stronę.
Blokada trenowania to nie to samo co blokada cytowania. Możesz nie chcieć, żeby Meta uczyła modele na Twoich tekstach, a jednocześnie chcieć, żeby Meta AI polecała Twoją firmę. Wtedy meta-webindexer zostawiasz.
Jeśli nie chcesz pojawiać się w Meta AI w ogóle, dopisz:
User-agent: meta-webindexer
Disallow: /
A FacebookBot?
W wielu poradnikach przewija się FacebookBot. W aktualnej dokumentacji crawlerów Meta go nie ma. Możesz go dopisać na zapas, nie zaszkodzi, ale nie zakładaj, że to on dziś skanuje Twoją stronę.
Zrób to do 29 października
Meta może zobaczyć zmiany w robots.txt dopiero po maksymalnie 24 godzinach (cache). Jeśli chcesz, żeby blokada działała 30.10, wgraj ją najpóźniej 29.10.
Czego robots.txt nie załatwi
robots.txt to prośba do botów, nie zamek w drzwiach. Granice są konkretne:
meta-externalfetcherifacebookexternalhitmogą go pominąć. Tak mówi sama dokumentacja Meta (ten drugi przy kontrolach bezpieczeństwa).- Regulamin nie wspomina o robots.txt ani słowem. Prawnicy cytowani przez Nieman Lab (wszyscy z USA) widzą ryzyko, że Meta uzna zgodę z regulaminu za ważniejszą niż instrukcje blokowania. Matt Topic (Loevy & Loevy) mówi, że nie wiadomo, czy sąd by to egzekwował, ale lepiej zakładać, że tak. Meta z kolei zapewnia, że aktualizacja nie daje jej nowych praw ponad ustawienia w robots.txt.
- Nie obejmuje treści na samym Facebooku i Instagramie. To, co publikujesz na fanpage'u, podlega osobnej licencji w tym samym regulaminie („Licencje i prawa udzielone Meta przez użytkownika”). robots.txt Twojej strony nic tu nie zmienia.
- Nie rozwiązuje kwestii danych logowania na potrzeby testów. To zapis w regulaminie, nie ustawienie bota.
Twardsza blokada, np. w firewallu po user-agencie albo adresie IP, to sprawa hostingu i konfiguracji serwera. Jeśli to dla Ciebie ważne, zapytaj swojego dostawcę hostingu.
A polskie prawo?
Prawo autorskie, art. 26³, pozwala na eksplorację tekstów i danych, „chyba że uprawniony zastrzegł inaczej”. Dla treści w internecie zastrzeżenie robi się „w formacie przeznaczonym do odczytu maszynowego”, razem z metadanymi.
Czy robots.txt spełnia ten wymóg? Nie znaleźliśmy źródła, które to rozstrzyga. Tak samo nie wiemy, jak zgoda z regulaminu Meta ma się do takiego zastrzeżenia. To pytanie otwarte i nie udajemy, że znamy odpowiedź. Jeśli Twój biznes stoi na treściach (wydawnictwo, płatne kursy, bazy wiedzy), skonsultuj to z prawnikiem.
Checklista przed 30 października
- Sprawdź, z czego korzysta Twoja firma. Fanpage, konto firmowe na IG, Business Suite, Menedżer reklam, WhatsApp Business. Jeśli z czegokolwiek z tej listy, regulamin Cię dotyczy.
- Otwórz robots.txt swojej strony. Wpisz w przeglądarce
twojadomena.pl/robots.txt. - Dopisz blok dla
meta-externalagentimeta-externalads. - Zdecyduj o
meta-webindexer. Chcesz być w Meta AI czy nie? - Zostaw
facebookexternalhit. Podglądy linków mają działać. - Wgraj zmiany najpóźniej 29.10. Meta potrzebuje do 24 godzin, żeby je zobaczyć.
- Sprawdź po wgraniu, czy plik się otwiera i czy stare reguły zostały na miejscu.
- Podejmij świadomą decyzję: zostajesz na platformach Meta na nowych zasadach albo z nich wychodzisz. Trzeciej opcji regulamin nie daje.
Nie wiesz, jak edytować robots.txt na swojej stronie (WordPress, Shoper, Wix) albo czy blokować Meta AI? Napisz do nas, sprawdzimy to w 15 minut.