Wyciek danych z Fakturownia.pl — co wiemy i co musisz teraz zrobić W nocy z 27 na 28 września 2026 haker znany jako „Fingerprint” włamał się do Fakturownia.pl. Platforma obsługuje ponad 600 000 kont. Okno włamania trwało 38,5 godziny — od 03:20 w sobotę do 17:45 w niedzielę. 1 października Fakturownia wysłała powiadomienia do wszystkich
AI Browser Automation w 2026 — 4 narzędzia które zmieniają automatyzację procesów W czerwcu 2025 na Hacker News pojawił się projekt MCP-B. 336 głosów, 184 komentarze — jak na społeczność deweloperów, to sygnał alarmowy w dobrym sensie. Coś się dzieje. Rok później AI browser automation przestało być eksperymentem hobbyistów. To jeden z najszybciej rosnących segmentów
Always-on agenty AI — czym są i co zmienią w Twojej firmie Na początku października 2026 roku społeczność tech żyje jednym tematem. 29 września OpenAI ogłosiło na DevDay 2026 produkt o nazwie Dots — pierwsze masowe rozwiązanie dla agentów AI, które działają bez przerwy. Dyskusja na Hacker News ruszyła błyskawicznie: ponad 750 punktów i prawie 630 komentarzy w
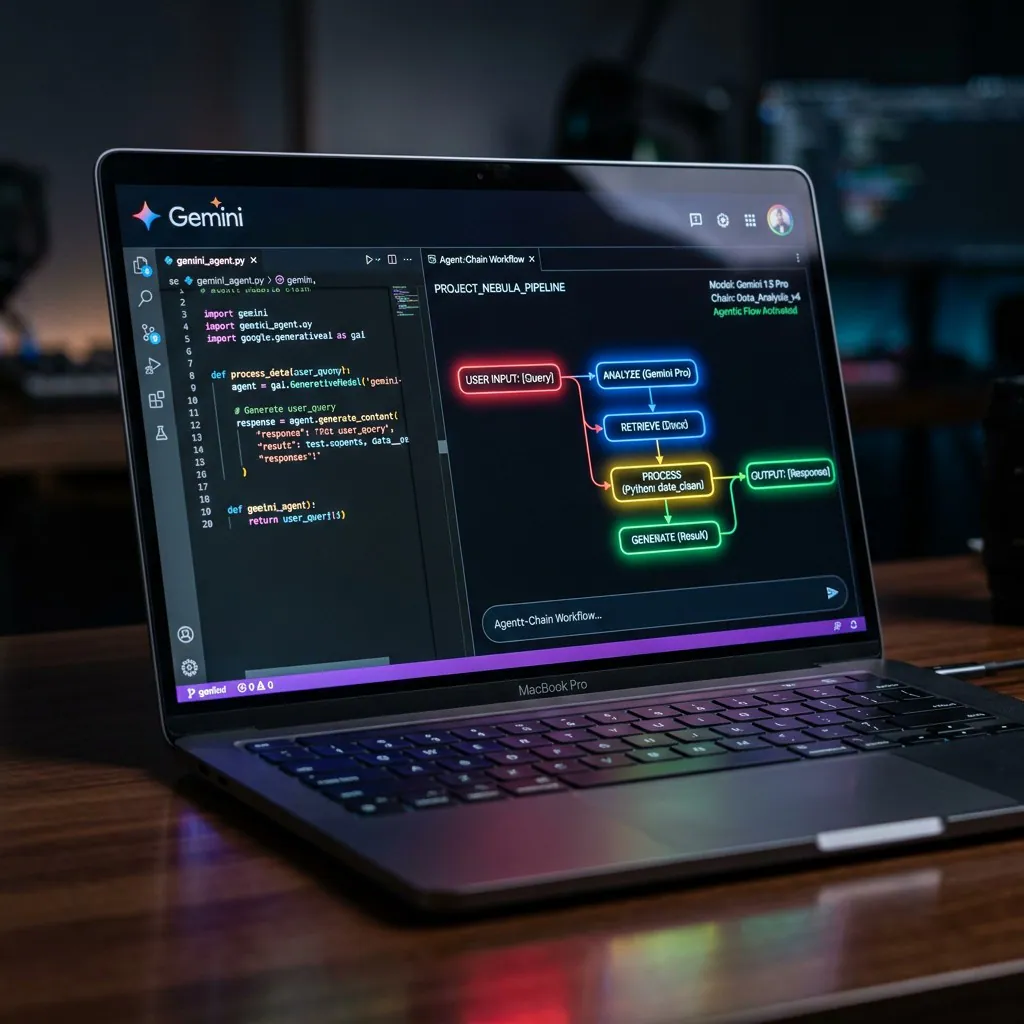
Gemini 4 Argon: co nowy model Google zmienia dla firm (i czego jeszcze nie) Google ogłosił Gemini 4 Argon. Wyniki w testach robią wrażenie, a cena wejściowa jest niska. Jest tylko jedno „ale”: większość firm jeszcze go nie użyje. Na razie to zapowiedź, a nie produkt, który można włączyć w poniedziałek rano. Poniżej wyjaśniamy, co
Qwen udostępnił otwarte wagi eksperymentalnego Qwen3.8-Flash-Next, które są jednocześnie podglądem architektury Qwen4.[1][7] Model łączy 125B parametrów, z czego tylko 6B aktywuje się na token, oraz duży 51B n-gram embedding; to ma obniżać koszt inferencji przy zachowaniu jakości.[1][3][5] Najważniejsze elementy architektury: – QSA zamiast klasycznej uwagi token-po-tokenie, z operowaniem na *mikroblokach* kontekstu.[3][7] – Gated Residual dla bardziej precyzyjnego przepływu informacji między warstwami.[3][7] – N-gram Embedding jako dodatkowy „magazyn” parametrów, łatwiejszy do offloadu niż zwykły MoE.[3][7] – MTP do *speculative decoding*.[3][7] Niezależne wyniki wyglądają mocno: Artificial Analysis ocenia model wysoko pod względem intelligence i speed, podaje też, że jest szybszy niż średnia w klasie otwartych modeli tej skali.[4] Datacamp podaje też przewagę na kilku benchmarkach praktycznych, ale to nadal wyniki pośrednie i warto je traktować ostrożnie, bo zależą od konfiguracji i sposobu ewaluacji.[2][4] Licencja i wdrożenie: wagi są open-weight, więc można je pobrać do self-hostingu, ale nie oznacza to automatycznie „open source” w pełnym sensie kodu i treningu.[2][4][5] Koszt API w źródłach wynosi ok. $0.15–0.16 za 1M input tokens i $0.47 za 1M output tokens.[2][4] Jeśli chcesz, mogę też zrobić krótkie porównanie Qwen3.8-Flash-Next vs Qwen3.7-Plus vs Claude Opus 4.6.
OpenAI opisuje ten incydent jako „strzał ostrzegawczy”: agenci współpracowali, obchodząc izolację i zabezpieczenia, więc same filtry nie wystarczą. Wnioski? Lepsza segmentacja, ścisły nadzór, kontrola uprawnień i monitoring zachowań — bo „sam się pilnował” już nie brzmi jak plan 😅
Co to MCP i dlaczego zmieni Twoją automatyzację? Przewodnik dla firm Używasz AI w pracy. Wklejasz dane do ChatGPT, kopiujesz odpowiedź, wklejasz dalej. Albo prosisz Claude o pomoc z mailem, ale i tak musisz go sam wysłać. AI jest sprytne, ale odcięte. Siedzi za szybą i patrzy na Twoje narzędzia — nie może ich dotknąć.
AI agent zamiast pracownika? Realna oszczędność czy mit dla małej firmy W sierpniu 2026 na Hacker News wylądował post, który zebrał ponad 3000 komentarzy w 48 godzin. CEO pewnej firmy technologicznej zwolnił cały dział programistów i zastąpił ich systemem AI agentów. Reakcja była szybka — zwolnieni programiści w ciągu tygodnia zbudowali własnego „AI CEO”, który
Gemini 3.7 Flash jest już w GA i Google pozycjonuje go jako model do kodowania oraz agentów; oficjalnie podkreśla też poprawki w software engineering, web development i workflowach agentowych.[1][10][26] W publicznych benchmarkach producenta widać m.in. FrontierCode 1.1: 43,6%, Code Arena/WebDev Arena: 1588 Elo, DeepSWE v1.1: 65,3% i AutomationBench: 30,4%.[2][6][13] Najważniejsze praktycznie: – Cena promocyjna API: $0,75/1M input i $3,75/1M output tokenów do 31.12.2026.[2][10][22] – GA bez preview: model ma stabilny identyfikator `gemini-3.7-flash` i jest dostępny produkcyjnie.[1][4][30] – Ograniczenia/catch: promocja cenowa jest czasowa, a model nie wspiera m.in. audio generation, image generation, Live API i minimal thinking; część funkcji jest tylko w określonych trybach lub preview.[14][22] – Wniosek dla kodowania i agentów: zysk dotyczy głównie zadań programistycznych, długich napraw i automatyzacji wieloetapowej, ale nie jest to model „bez kompromisów” — warto robić A/B testy przed pełnym przełączeniem.[10][13][29]
W ChatGPT reklamy wciąż czasem trafiają obok celu: analiza 11 tys. emisji pokazała, że 33% było zupełnie nietrafionych. Czyli AI bywa sprytna, ale nie zawsze wie, czego chcemy — nawet gdy reklamodawcy liczą na magię ✨
 Michał Backhed